指南
ASCII、Unicode 与 UTF-8:实用差异解析
总是分不清 ASCII、Unicode 和 UTF-8?这篇指南用实际例子、编码层级、调试场景和常见坑位,帮你彻底理清三者关系。
1 分钟阅读
作者 Binary Code Translator#ascii#unicode#utf-8#encoding#debugging
如果您曾经在日志中看到过“乱码”或在 UI 中看到过问号菱形,那么本文适合您。
简短版本:
- ASCII 是一个古老的字符集(主要是英语)。
- Unicode 是全球字符标准(您指的是什么字符)。
- UTF-8 是一种编码格式(字符如何存储为字节)。
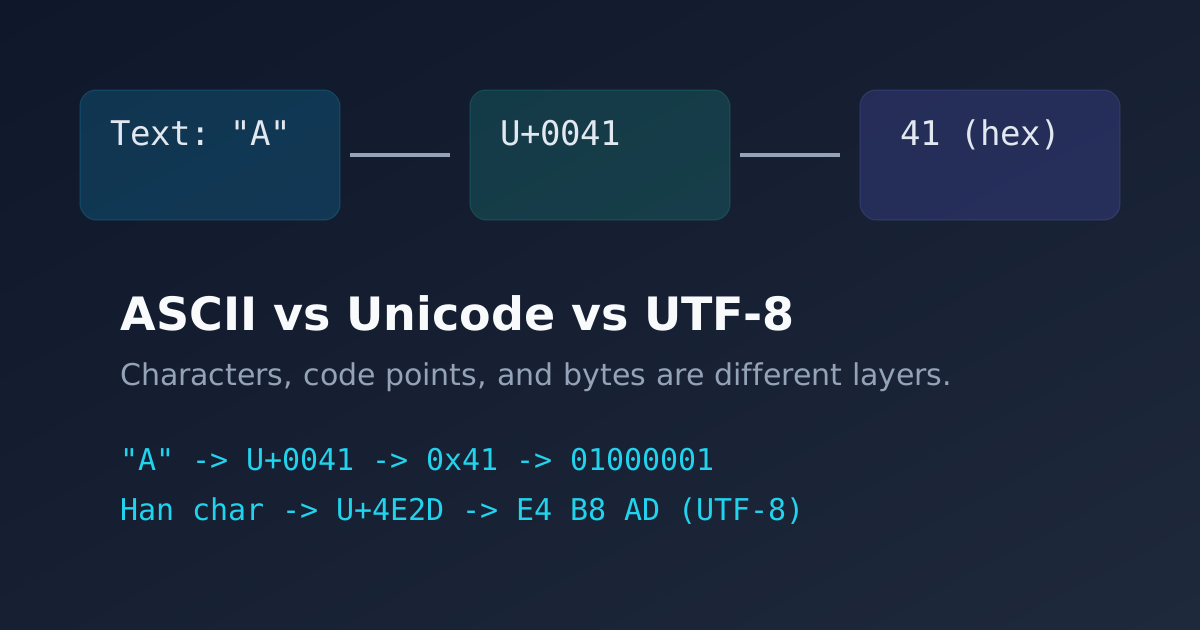
一个概念,三层
分层思考:
- 字符:人类阅读的内容,如
A。 - 代码点:Unicode id,如
U+0041。 - 字节:存储形式,如十六进制的
41(UTF-8的二进制为01000001)。
对于非 ASCII 示例:
- 字符:汉字“中”。
- 代码点:
U+4E2D。 - UTF-8 字节:
E4 B8 AD。
为什么 ASCII 仍然很重要
ASCII 只有 128 个字符。它体积小、稳定,并且仍然用于:
- 网络协议
- 旧文件格式
- 命令行工具
好消息:UTF-8 向后兼容 ASCII,因此旧的英文文本仍然可以使用。
为什么 Unicode 很重要
Unicode 赋予每个字符一个唯一的 ID。它不依赖于一种语言。
如果没有 Unicode,现代应用程序将在以下情况下失败:
- 多语言名称
- 货币符号
- 表情符号和类似图标的字符
为什么 UTF-8 成为 Web 默认值
UTF-8 之所以流行,是因为它平衡了兼容性和空间:
- 英文文本保持紧凑。
- 支持国际文本。
- 大多数浏览器、API 和数据库默认使用 UTF-8。
“Mojibake”的快速调试清单
当文本看起来损坏时:
- 在编辑器中确认文件编码(UTF-8)。
- 确认 HTTP 标头包含字符集:
Content-Type: text/html; charset=utf-8- 确认数据库连接和列排序规则。
- 确认复制/粘贴管道未转换编码。
- 确认您的终端字体支持该字符。
迷你实验室
在您的转换器中尝试这些:
- 将
Hello转换为二进制并返回。 - 转换带有符号的混合文本。
- 比较短英文文本和多语言文本的字节长度。
最后要点
将编码视为基础设施,而不是装饰。大多数文本错误的发生是因为一个系统采用与另一个系统不同的层。
如果你记得一行,请记住这一点:
Unicode 定义字符;UTF-8 定义字节。
参考
- Unicode 标准
- MDN 上的 UTF-8
- RFC 3629:UTF-8