ASCII, Unicode y UTF-8: diferencias con ejemplos
Distingue caracteres, puntos de código y bytes; compara ASCII con Unicode y UTF-8 y aprende a diagnosticar texto dañado sin confundir sus capas.
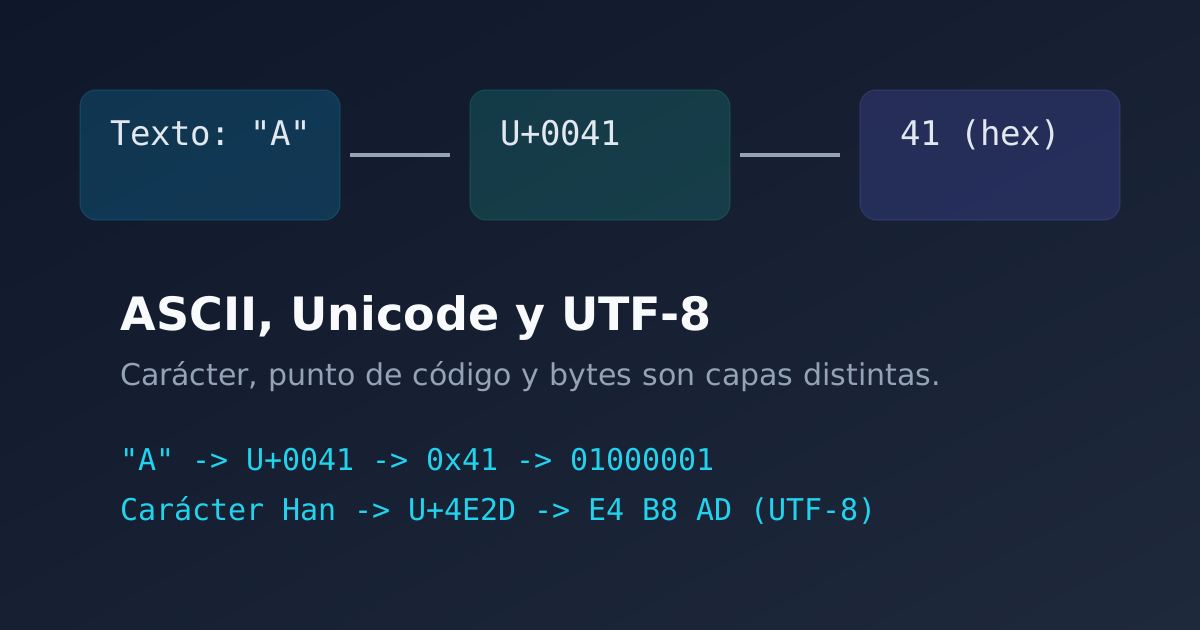
ASCII, Unicode y UTF-8 aparecen juntos en documentación, cabeceras HTTP y opciones de bases de datos, pero no nombran lo mismo. La distinción útil es sencilla: ASCII es un repertorio histórico de caracteres y códigos; Unicode asigna puntos de código; UTF-8 convierte esos puntos de código en bytes.
Entender esas tres capas evita buena parte del texto ilegible que suele llamarse mojibake.
Carácter, punto de código y byte
Un carácter es la unidad de texto que intentas representar. Unicode le asigna un punto de código, escrito normalmente como U+ seguido de cifras hexadecimales. Una codificación transforma después ese valor en una secuencia de bytes.
Para A:
- carácter:
A; - punto de código Unicode:
U+0041; - bytes UTF-8 en hexadecimal:
41; - representación binaria del byte:
01000001.
Para ñ:
- carácter:
ñ; - punto de código:
U+00F1; - bytes UTF-8:
C3 B1; - binario:
11000011 10110001.
La segunda letra ocupa dos bytes en UTF-8. Por eso no conviene afirmar que «un carácter equivale a un byte». Tampoco todos los elementos que una persona percibe como un único símbolo corresponden a un solo punto de código: algunos emoji y letras con marcas combinadas usan secuencias de varios puntos.
Qué cubre ASCII
ASCII define 128 códigos, del 0 al 127. Incluye letras latinas sin acentos, dígitos, puntuación y caracteres de control como salto de línea o tabulación. Es un estándar de 7 bits, aunque sus valores suelen guardarse dentro de bytes de 8 bits.
UTF-8 conserva los valores ASCII: los puntos U+0000 a U+007F se representan con el mismo byte numérico. Esa compatibilidad explica por qué archivos antiguos en inglés suelen abrirse correctamente como UTF-8.
Consulta valores concretos en la tabla ASCII o prueba su representación con el conversor de texto a binario.
Qué aporta Unicode
Unicode proporciona un sistema común para escrituras, símbolos, emoji y controles. Un punto de código identifica un valor del espacio Unicode, pero no decide cómo se almacena. Esa tarea corresponde a formatos como UTF-8, UTF-16 o UTF-32.
Unicode tampoco equivale a «todos los glifos». La forma visible depende de la fuente, y un mismo texto puede tener secuencias canónicamente equivalentes. Cuando depures comparaciones, nombres de archivo o identificadores, revisa también la normalización.
El conversor de escapes Unicode permite inspeccionar puntos de código y unidades sustitutas UTF-16 sin ejecutar el texto.
Cómo funciona UTF-8
UTF-8 usa entre uno y cuatro bytes por punto de código Unicode válido:
| Rango | Bytes UTF-8 | Ejemplo |
|---|---|---|
U+0000–U+007F |
1 | A |
U+0080–U+07FF |
2 | ñ |
U+0800–U+FFFF |
3 | 中 |
U+10000–U+10FFFF |
4 | 😀 |
Los patrones de bits iniciales indican la longitud de la secuencia. No todas las combinaciones de bytes son válidas: UTF-8 prohíbe codificaciones sobredimensionadas, puntos sustitutos y valores fuera del rango Unicode.
Diagnóstico de texto dañado
Cuando una palabra acentuada muestra varios caracteres inesperados, normalmente sus bytes UTF-8 se han interpretado como otra codificación. El símbolo de sustitución U+FFFD indica que algún decodificador encontró bytes que no pudo convertir.
Revisa el recorrido completo:
- Confirma la codificación con la que se guardó el archivo.
- Comprueba la cabecera HTTP, por ejemplo
Content-Type: text/html; charset=utf-8. - Verifica la codificación de la conexión y de las columnas de la base de datos.
- Evita decodificar dos veces una cadena ya interpretada.
- Compara los bytes originales antes de culpar a la fuente o a la interfaz.
La herramienta de texto a hexadecimal ayuda a ver los bytes UTF-8 exactos; el conversor de binario a texto sirve cuando la entrada ya está expresada en grupos binarios.
Idea clave
ASCII, Unicode y UTF-8 encajan en niveles distintos. Pregunta primero si estás observando caracteres, puntos de código, unidades de código o bytes. Una vez identificada la capa, el error deja de parecer misterioso y puede reproducirse con datos concretos.