ASCII, Unicode und UTF-8: die Unterschiede erklärt
ASCII, Unicode und UTF-8 verständlich erklärt: Erfahre, wie Zeichen, Codepoints und Bytes zusammenhängen und wie du typische Kodierungsfehler behebst.
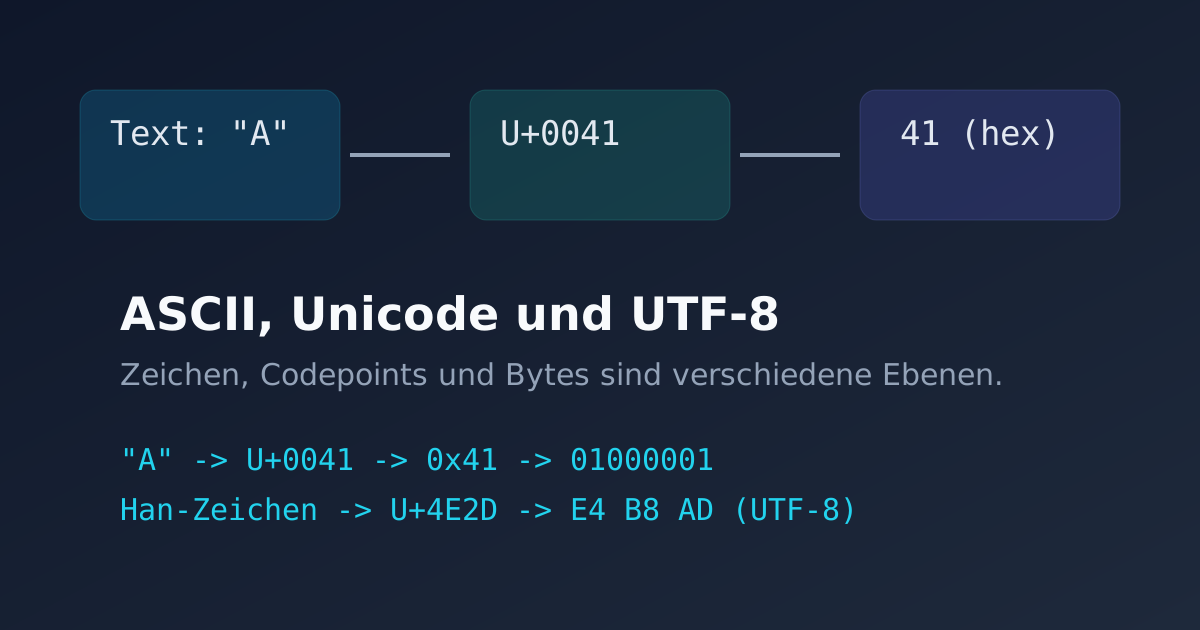
ASCII, Unicode und UTF-8 werden oft in einem Atemzug genannt, bezeichnen aber nicht dasselbe. Wer die drei Ebenen sauber trennt, kann fehlerhafte Umlaute, schwarze Rauten mit Fragezeichen und andere Kodierungsprobleme gezielt untersuchen.
Die Kurzfassung:
- ASCII ist ein kleiner, historischer Zeichensatz mit 128 Zeichen.
- Unicode weist Zeichen weltweit eindeutige Codepoints zu.
- UTF-8 legt fest, wie diese Codepoints als Bytefolgen gespeichert werden.
ASCII: 128 Zeichen aus der Frühzeit der Datenverarbeitung
ASCII steht für American Standard Code for Information Interchange. Der Standard nutzt sieben Bit und umfasst die Werte 0 bis 127. Dazu gehören lateinische Groß- und Kleinbuchstaben ohne Akzente, Ziffern, Satzzeichen sowie Steuerzeichen wie Zeilenumbruch und Tabulator.
Ein Beispiel: Der Großbuchstabe A hat in ASCII den Dezimalwert 65. Als acht Bit dargestellt lautet dieser Wert 01000001. Das führende Nullbit gehört nicht zum ursprünglichen Sieben-Bit-Standard, ist aber in einer Byte-Darstellung üblich.
ASCII deckt weder deutsche Umlaute noch das Eurozeichen oder Emoji ab. Frühere sogenannte „erweiterte ASCII“-Tabellen nutzten die Werte 128 bis 255 unterschiedlich. Ohne Angabe der konkreten Codepage war deshalb nicht eindeutig, welches Zeichen ein Byte meinte.
Unicode: ein gemeinsamer Nummernraum für Zeichen
Unicode löst dieses Zuordnungsproblem. Der Standard vergibt für jedes aufgenommene Zeichen einen Codepoint, geschrieben als U+ plus Hexadezimalwert. Beispiele:
| Zeichen | Unicode-Codepoint |
|---|---|
A |
U+0041 |
ä |
U+00E4 |
€ |
U+20AC |
😀 |
U+1F600 |
Ein Codepoint ist noch keine Datei- oder Netzwerkdarstellung. Er bezeichnet ein Zeichen im Unicode-Nummernraum. Erst eine Kodierung wie UTF-8, UTF-16 oder UTF-32 übersetzt den Codepoint in Bytes.
UTF-8: Unicode als variable Bytefolge
UTF-8 kodiert einen Unicode-Codepoint mit einem bis vier Bytes:
- ASCII-Zeichen benötigen ein Byte.
- Viele lateinische Buchstaben mit Akzent oder Umlaut benötigen zwei Bytes.
- Zahlreiche andere Schriftzeichen benötigen drei Bytes.
- Zeichen außerhalb der Basic Multilingual Plane, darunter viele Emoji, benötigen vier Bytes.
Diese variable Länge spart bei überwiegend ASCII-basiertem Text Platz. Zugleich ist UTF-8 für die ersten 128 Zeichen byteweise mit ASCII kompatibel: A wird in beiden Fällen als 0x41 gespeichert.
Ein deutsches Beispiel zeigt, warum „ein Zeichen entspricht einem Byte“ falsch ist. Das Wort Grüße hat fünf sichtbare Buchstaben, belegt in UTF-8 aber sieben Bytes: G, r, e sind jeweils ein Byte, ü und ß jeweils zwei.
So entsteht fehlerhafter Text
Zeichensalat entsteht meist nicht durch beschädigte Daten, sondern durch eine falsche Interpretation derselben Bytes. Wird etwa die UTF-8-Bytefolge für ü als Windows-1252 gelesen, erscheinen häufig zwei falsche Zeichen. Das Unicode-Ersatzzeichen U+FFFD bedeutet dagegen meist, dass eine Bytefolge in der erwarteten Kodierung ungültig war.
Bei der Fehlersuche helfen vier Fragen:
- In welcher Kodierung wurden die Bytes erzeugt?
- Welche Kodierung erwartet der Empfänger?
- Wird die Kodierung in HTTP-Headern, HTML oder Dateimetadaten eindeutig angegeben?
- Wurde Text zwischendurch unnötig dekodiert und erneut kodiert?
Für Webseiten ist UTF-8 heute die sinnvolle Vorgabe. Verwende im HTML <meta charset="utf-8"> und sende einen passenden Content-Type-Header. Datenbanken, Editor, Anwendung und Schnittstelle sollten dieselbe Festlegung verwenden.
Praktisch prüfen statt raten
Mit dem Text-in-Binär-Konverter kannst du sehen, welche UTF-8-Bits zu einem Text gehören. Der Unicode-Escape-Konverter zeigt Codepoints beziehungsweise Escape-Sequenzen. Mit der Umwandlung von ASCII-Text in Binär kannst du einzelne ASCII-Zeichen als 8-Bit-Gruppen prüfen.
Dabei gilt:
- ASCII beantwortet: Welche Nummer hat ein Zeichen im kleinen historischen Zeichensatz?
- Unicode beantwortet: Welcher Codepoint bezeichnet das Zeichen?
- UTF-8 beantwortet: Welche Bytes stellen diesen Codepoint dar?
Wer diese Fragen getrennt hält, erkennt auch den häufigsten Denkfehler: Unicode ist keine einzelne Bytekodierung und UTF-8 ist kein eigener Zeichensatz. Die maßgeblichen technischen Details stehen im Unicode Standard und in RFC 3629.