Texto a binario: 10 errores comunes y soluciones
Diagnostica bits no válidos, bytes incompletos, UTF-8 mal interpretado, espacios invisibles y conversiones en la dirección equivocada.
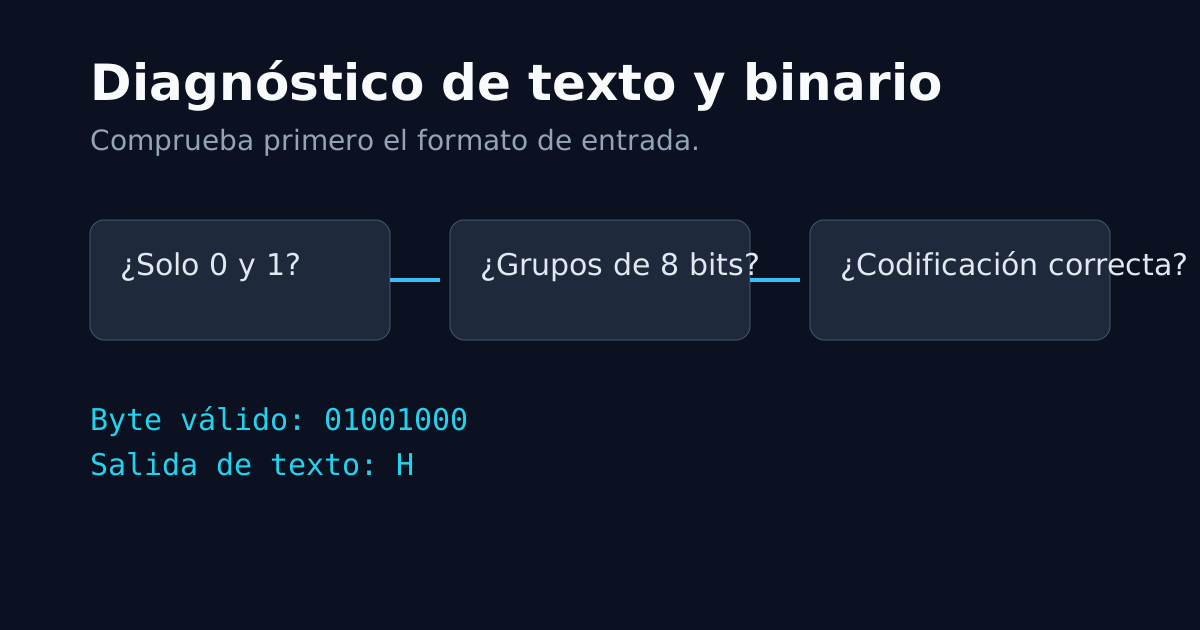
Una conversión entre texto y binario solo es correcta si la entrada, el ancho de los grupos y la codificación coinciden. Cuando el resultado parece ilegible, evita probar cambios al azar: identifica primero qué representan los bits.
Estos diez fallos cubren la mayoría de los problemas reproducibles.
1. La entrada contiene dígitos que no son binarios
Una secuencia binaria solo puede contener 0 y 1. Los espacios u otros separadores pueden admitirse como formato, pero 2, A o 0x pertenecen a otras notaciones.
Entrada no válida:
01012001Si la fuente mezcla decimal, hexadecimal y binario, convierte primero cada unidad a una base común con el conversor de bases.
2. Los bytes están incompletos
Para texto codificado como bytes, la cadena suele agruparse de ocho en ocho:
01001000 01101111 01101100 01100001Un grupo final como 0101 no forma un byte completo. No añadas ceros sin conocer el protocolo: rellenar a la izquierda cambia el ancho; rellenar a la derecha cambia el valor.
3. Se perdió un cero inicial
El valor binario de A puede escribirse matemáticamente como 1000001, pero su byte ASCII completo es 01000001. Si concatenas varios valores sin conservar ocho bits, los límites se desplazan y el texto deja de ser recuperable de forma inequívoca.
Usa el conversor de binario a texto y mantén los separadores durante la depuración.
4. Se eligió la dirección incorrecta
Texto a binario y binario a texto son operaciones inversas. Si pegas Hola en un campo que espera bits, debe aparecer un error, no la misma palabra. Comprueba las etiquetas de entrada y salida antes de cambiar los datos.
La página principal del traductor binario detecta entradas habituales, pero una secuencia compuesta solo por 0 y 1 puede ser ambigua: podría ser texto literal o bits. Selecciona un conversor direccional cuando la intención importe.
5. Se confundió ASCII con UTF-8
ASCII cubre 128 códigos. UTF-8 conserva ese rango y añade el resto de Unicode mediante secuencias multibyte. A ocupa un byte; ñ ocupa dos; muchos emoji ocupan cuatro.
Si un decodificador procesa cada byte no ASCII como un carácter independiente, aparecen varios símbolos inesperados en lugar de la letra original. Usa UTF-8 de extremo a extremo y consulta ASCII, Unicode y UTF-8 para separar las capas.
6. Hay espacios invisibles o saltos distintos
Un espacio normal es el byte 20 hexadecimal; un salto LF es 0A; en muchos archivos Windows, un final de línea es CRLF (0D 0A). Tabulaciones, espacios no separables y marcas de ancho cero también cambian los bytes.
No elimines todo el espacio en blanco si forma parte del texto original. Examina la secuencia con el conversor de texto a hexadecimal para distinguir contenido y separadores de presentación.
7. Se escribió una secuencia de escape literal
Los dos caracteres \ y n no son lo mismo que un salto de línea. En un lenguaje de programación, "\n" puede convertirse en LF al interpretar el literal; en un formulario de texto puede permanecer como dos caracteres.
Anota siempre si trabajas con código fuente, texto ya interpretado o bytes de archivo.
8. Se aplicó una codificación dos veces
Si conviertes bytes UTF-8 en texto y vuelves a interpretar ese texto con una codificación incompatible, obtendrás mojibake. Otro caso habitual es decodificar Base64 dos veces o aplicar percent-encoding a una cadena que ya estaba codificada.
Registra cada transformación y conserva un ejemplo conocido para comprobar la ida y vuelta.
9. Se copiaron caracteres de formato
Procesadores de texto y páginas web pueden introducir comillas tipográficas, guiones largos, espacios no separables o marcas bidireccionales. Se ven parecidos, pero tienen puntos de código y bytes distintos.
Pega primero en un editor de texto sin formato o inspecciona los puntos de código con la herramienta de escapes Unicode. No sustituyas caracteres automáticamente si su identidad es relevante.
10. El siguiente sistema espera otra cosa
Una conversión local puede ser correcta y aun así fallar en una API. El receptor quizá espere:
- Base64 en lugar de una cadena de
0y1; - bytes en orden little-endian;
- un entero con signo y ancho fijo;
- UTF-16 en lugar de UTF-8;
- delimitadores, longitud o checksum adicionales.
Consulta la especificación del formato. «Binario» puede significar un archivo de bytes, un número en base 2 o una cadena textual de bits; no son intercambiables.
Lista de comprobación
- ¿Qué tipo de dato representa la entrada?
- ¿La cadena contiene solo símbolos válidos?
- ¿Los grupos y el ancho son correctos?
- ¿Conoces la codificación de caracteres?
- ¿Los espacios forman parte de los datos?
- ¿La ida y vuelta recupera exactamente el original?
- ¿El sistema receptor exige otro formato?