Texto para binário: 10 erros comuns e como os corrigir
Resolva entradas com bits inválidos, grupos incompletos, UTF-8 mal interpretado, espaços ambíguos e outros problemas frequentes na conversão de texto e binário.
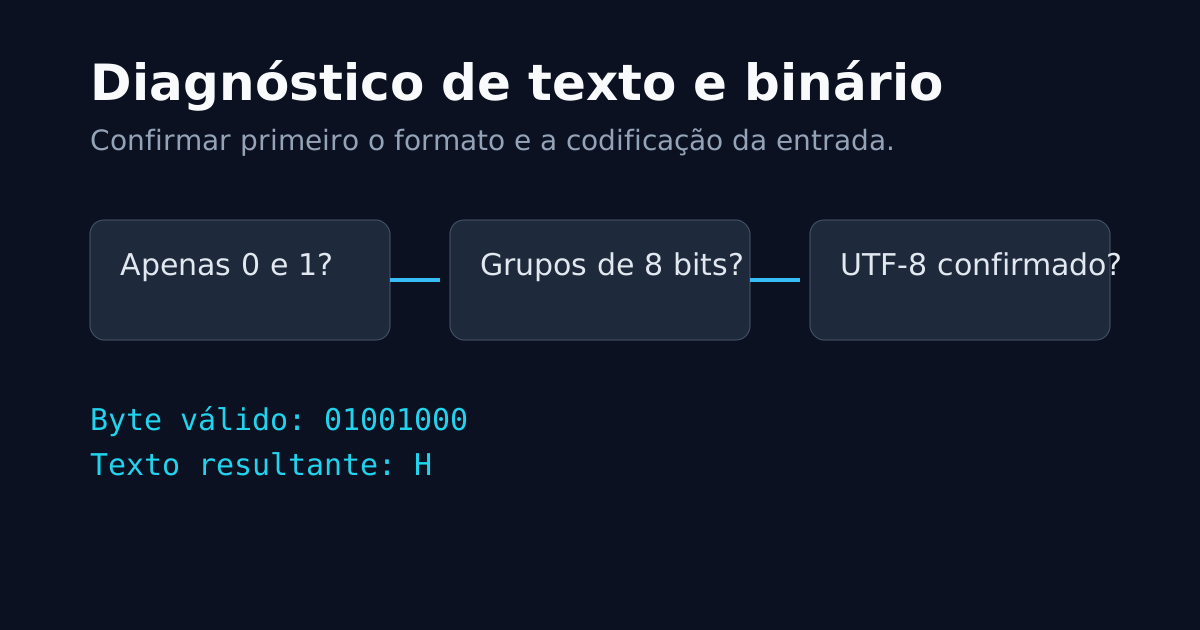
Quando uma conversão falha, a causa costuma estar nos dados de entrada ou numa suposição sobre a codificação. Este roteiro separa os problemas mais frequentes.
1. A entrada contém símbolos que não são bits
Uma cadeia binária só deve conter 0 e 1, além dos separadores aceites pela ferramenta. Prefixos como 0b, vírgulas ou comentários podem ser válidos noutro contexto, mas não fazem necessariamente parte do formato esperado.
01000001 0100001X ← X inválidoRemova o símbolo ou confirme o formato de origem antes de converter.
2. Falta um bit num grupo
Para texto baseado em bytes, agrupe a entrada de oito em oito bits. Um grupo de sete bits pode representar ASCII clássico, mas misturá-lo com bytes de oito bits desloca todos os limites seguintes.
01000001 01000010   ✓
1000001  1000010    requer uma regra explícita de 7 bits
Não acrescente zeros sem conhecer a largura e a extremidade (endianness) da fonte.
3. Os zeros à esquerda desapareceram
O valor decimal 5 pode escrever-se 101, mas num byte é 00000101. Folhas de cálculo e conversões numéricas tendem a eliminar zeros iniciais. Guarde sequências de bits como texto quando a largura for relevante.
4. Os espaços têm dois significados
Um espaço entre grupos costuma ser apenas um separador visual. O caráter de espaço, em ASCII e UTF-8, é o byte 00100000. Se a origem removeu todos os separadores, preserve a largura de oito bits para reconstruir os bytes.
5. Foi escolhida a codificação errada
ASCII cobre apenas 128 valores. Texto português moderno deve, em regra, ser tratado como Unicode e codificado em UTF-8. á torna-se C3 A1 em UTF-8; interpretar cada byte isoladamente como um caráter produz texto ilegível.
6. Bits e algarismos binários foram confundidos com texto
A cadeia textual 01000001 contém oito carateres visíveis. O byte binário 01000001 é um valor único, 65, que corresponde a A em ASCII/UTF-8. Confirme se a entrada é um ficheiro binário, uma representação textual de bits ou um número.
7. A ordem dos bytes está invertida
UTF-8 tem uma ordem de bytes definida e não usa variantes little-endian. Já inteiros e unidades UTF-16 podem ser guardados com ordens diferentes. Inverter bytes sem conhecer o tipo de dados não corrige uma codificação desconhecida.
8. Quebras de linha foram normalizadas
Windows usa frequentemente CRLF (0D 0A); Unix e sistemas modernos usam normalmente LF (0A). Um editor pode alterar essas sequências ao abrir ou guardar um ficheiro. Compare os bytes, não apenas o aspeto do texto.
9. A entrada foi truncada
Um byte UTF-8 inicial indica quantos bytes compõem a sequência. Se faltar um byte de continuação, a sequência deixa de ser válida e pode aparecer o caráter de substituição U+FFFD. Recupere os dados originais em vez de tentar adivinhar o byte ausente.
10. Esperava-se segurança de uma codificação
Converter texto em binário ou Base64 não o encripta e não comprova a sua integridade. Se o objetivo for confidencialidade, autenticação ou deteção de alterações, use mecanismos criptográficos adequados e valide a implementação.
Lista de verificação
Antes de voltar a tentar:
- identifique o tipo de dados e a codificação declarada;
- conserve uma cópia dos bytes originais;
- valide símbolos e comprimento;
- confirme a largura dos grupos;
- teste um exemplo pequeno cujo resultado seja conhecido;
- só depois altere separadores, ordem ou codificação.
O conversor de binário para texto permite testar grupos de bits no navegador. Para inspecionar bytes com menos ruído visual, o conversor de texto para hexadecimal mostra cada byte UTF-8 com dois algarismos hexadecimais.